Preskočiť na obsah

LLM na vlastnom serveri a súkromné AI systémy

Prevádzkujte AI vo vlastnom prostredí, keď dáta nesmú ísť do verejných AI služieb

Niektoré dáta nesmú ísť do verejnej AI služby: klientske spisy, zdravotné záznamy, zmluvy, zdrojový kód. Staviame AI asistentov na otvorených modeloch, ktoré si môžete stiahnuť a prevádzkovať sami, napríklad Llama, Mistral alebo Qwen. Bežia vo vašom cloudovom účte alebo na vašich serveroch. Odpovedajú z vašich dokumentov a databáz s odkazom na zdroj a každý vidí len to, čo mu dovoľuje jeho rola. Ak vašim pravidlám vyhovuje firemné API s dátami v EÚ, povieme vám to, lebo je lacnejšie a začať sa dá rýchlejšie.

  • Modely bežia vo vašom cloude alebo na vašich serveroch
  • Odpovede z vašich dokumentov s odkazom na zdroj
  • Rovnaké prístupové práva ako vo vašich systémoch
  • Záznam každej otázky a odpovede zostáva u vás

Poznáte to?

Situácie, v ktorých sa nám firmy najčastejšie ozvú.

  1. Bezpečnostné alebo právne oddelenie zakázalo verejné AI nástroje na všetko, čo obsahuje údaje klientov.

  2. Zamestnanci aj tak vkladajú interné dokumenty do verejných chatbotov, lebo nič schválené im nepomôže.

  3. Chcete sa pýtať na zmluvy, smernice alebo spisy bez toho, aby ste ich niekam nahrávali.

  4. Zmluva s klientom alebo regulátor vyžaduje, aby dáta zostali vo vašej infraštruktúre alebo v jednej krajine.

  5. Pilot s AI ste spravili cez verejné API a teraz potrebujete riešenie, ktoré prejde vaším bezpečnostným posúdením.

Čo sa deje, keď sa niekto spýta.

Všetko tu beží vo vašom prostredí. Model je len jedna časť. Najviac práce je v hľadaní správnych dokumentov a dodržaní oprávnení.

  1. Zamestnanec sa spýta V chate, v Teams alebo priamo vo vašom nástroji
  2. Overia sa oprávnenia Len zdroje, ktoré tento človek smie otvoriť
  3. Nájdu sa správne pasáže Vyhľadávanie v dokumentoch a databázach podľa významu
  4. Model napíše odpoveď Na vašom serveri, len z nájdených pasáží
  5. Odpoveď so zdrojmi Odkazy na použité dokumenty a záznam v logu
Tento postup sa volá RAG (retrieval-augmented generation, teda generovanie odpovede s vyhľadávaním). Model sa na vašich dátach netrénuje. Zakaždým si prečíta relevantné pasáže, takže nové dokumenty sa rátajú hneď po zaindexovaní.

Čo sme sa naučili.

Čo hovoríme firmám skôr, než kúpia server s GPU.

  • 01

    Vlastný server možno nepotrebujete.

    Mnohé pravidlá pre dáta splní firemné API s dátami v EÚ, zmluvou o spracúvaní osobných údajov a bez trénovania na vašich dátach. Je lacnejšie a dostanete najsilnejšie modely. Vlastný server dáva zmysel, keď zmluvy, regulácia alebo vaše posúdenie rizík hovoria, že dáta nesmú opustiť vašu kontrolu. Alebo keď máte vysoký a stabilný objem.

  • 02

    Otvorené modely na väčšinu interných úloh stačia.

    Otvorené modely zvládajú zhrnutia, odpovede z dokumentov, vyťahovanie údajov aj návrhy textov. Pri náročnom uvažovaní a dlhých zložitých úlohách sú najlepšie komerčné modely stále vpredu. Skôr než sa rozhodnete, otestujte oboje na vašich skutočných otázkach, nie na verejných porovnaniach.

  • 03

    Vyhľadávanie je dôležitejšie ako model.

    Väčšina zlých odpovedí vzniká pri vyhľadávaní: naskenované PDF bez textovej vrstvy, staré verzie, dokumenty rozdelené na nesprávnych miestach. Upratanie a štruktúrovanie zdrojov zvyčajne zlepší odpovede viac ako väčší model.

  • 04

    Rátajte s prevádzkou, nielen s hardvérom.

    Server s GPU stojí peniaze, aj keď nič nerobí, a niekto musí aktualizovať model, sledovať ho a záplatovať systém. Prenájom GPU v cloude v EÚ je často lepší začiatok ako kúpa hardvéru. Kupujte, až keď je používanie stabilné a viete, aký veľký model potrebujete.

Čo vieme postaviť.

  • Súkromné nasadenie

    • Otvorené modely (Llama, Mistral, Qwen a podobné) na vašich serveroch alebo vo vašom cloudovom účte
    • Prenajaté GPU v cloude v EÚ alebo vlastný hardvér podľa počtu používateľov
    • Servery na beh modelov, napríklad vLLM alebo Ollama, za vaším firewallom
    • Hybridné riešenia, ktoré do API s dátami v EÚ posielajú len necitlivú prácu
  • Odpovede z vašich dát

    • Vyhľadávanie a odpovede nad SharePointom, Google Drive, zdieľanými diskami a wiki
    • Prístup na čítanie do databáz, CRM a ERP cez ich API
    • Odpovede s odkazom na zdrojový dokument a pasáž
    • Vyťahovanie textu zo skenov a PDF vrátane tabuliek
  • Prístup a kontrola

    • Jednotné prihlásenie cez vaše účty Microsoft alebo Google
    • Oprávnenia prevzaté zo zdrojových systémov
    • Záznamy otázok, odpovedí a zdrojov uložené vo vašom prostredí
    • Pravidlá pre témy, na ktoré asistent nesmie odpovedať
  • Prevádzka

    • Testovacie sady skutočných otázok na meranie kvality odpovedí
    • Sledovanie používania, rýchlosti a záťaže
    • Aktualizácie modelu otestované pred nasadením
    • Chat, aplikácia v Teams alebo AI priamo vo vašich nástrojoch

Verejné AI API, API s dátami v EÚ alebo model na vlastnom serveri?

Všetky tri sa dajú pri správnych dátach používať bezpečne. Rozdiel je v tom, kto vaše dáta spracúva a čo za kontrolu zaplatíte.

Verejné AI APIFiremné API s dátami v EÚModel na vlastnom serveri
Dáta zostávajú vo vašej infraštruktúre Nie Nie Áno
Dáta zostávajú v EÚ Čiastočne Áno Áno
Najsilnejšie modely Áno Áno Čiastočne
Čas do spustenia Dni Dni až týždne Týždne
Ako sa správajú náklady Platíte za použitie Platíte za použitie Väčšinou fixné
Kto udržiava model Poskytovateľ Poskytovateľ Vy alebo my
Funguje bez internetu Nie Nie Áno
Ak API s dátami v EÚ spĺňa vaše pravidlá, začnite ním. Je lacnejšie a rýchlejšie. Vlastný server dáva zmysel, keď dáta musia zostať pod vašou kontrolou alebo keď je objem taký veľký, že váš hardvér bude stále vyťažený.

Ako vzniká prvá verzia.

Bežný harmonogram. Ten váš potvrdíme po úvodnom workshope.

  1. 1. týždeň

    Pravidlá pre dáta a jedno použitie

    Prejdeme, o aké dáta ide a čo vyžadujú vaše pravidlá a zmluvy. Potom vyberieme jedno použitie s jasným vlastníkom, napríklad otázky k zmluvám alebo interným smerniciam. Dostanete fixnú cenu.

  2. 2. – 3. týždeň

    Test modelov na vašich otázkach

    Otvorené modely pustíme na sadu vašich skutočných otázok a porovnáme ich s API s dátami v EÚ. Rozdiel v kvalite uvidíte ešte pred rozhodnutím.

  3. 4. – 6. týždeň

    Nasadenie a prepojenie

    Nasadenie vo vašom cloude alebo na vašich serveroch, zdroje dokumentov, oprávnenia a záznamy. Každý týždeň funkčné demo.

  4. Potom

    Pilot a rozšírenie

    Jeden tím ho denne používa a my meriame kvalitu odpovedí. Potom pridáme ďalšie zdroje a tímy. Kód aj nastavenie sú vaše.

Prvá verzia zvyčajne trvá 6 týždňov až 3 mesiace. Nákup vlastného hardvéru môže pridať týždne, preto môže pilot začať na prenajatých GPU a presunúť sa neskôr.

Prípadové štúdie.

Systémy, ktoré sme postavili a ktoré sú tomuto blízke.

  • Shovels.ai

    Dáta v stavebníctve · Lafayette, Kalifornia

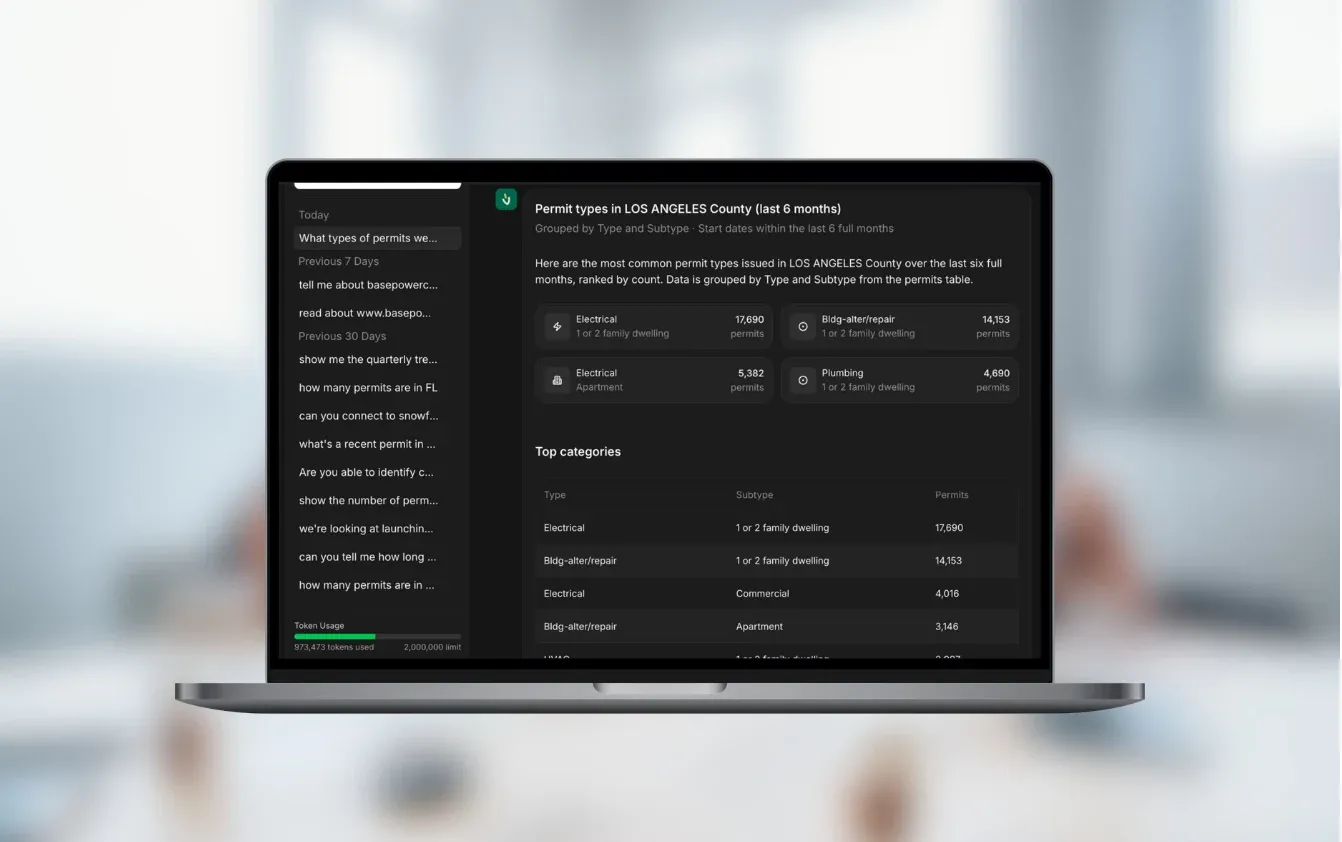
    Charlie: Otázky a odpovede o stavebných dátach

    AI asistent, ktorý odpovedá na otázky o stavebných povoleniach a zhotoviteľoch podľa aktuálnych údajov z databázy.

    Prečítať prípadovú štúdiu
  • Datair

    Dátová analytika · Bratislava, Slovensko

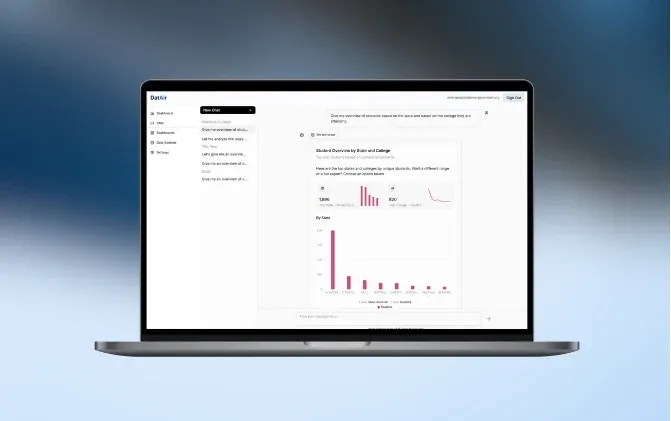
    AI dátový analytik

    Datair pomocou AI umožňuje analyzovať dáta a vytvárať reporty aj ľuďom bez technických znalostí.

    Prečítať prípadovú štúdiu

Časté otázky.

Potrebujeme vlastný hardvér?

Na začiatok nie. Pilot môže bežať na GPU prenajatých v cloude v EÚ, vo vašom vlastnom účte. Kúpa hardvéru dáva zmysel, keď je používanie stabilné a viete, aký veľký model potrebujete.

Je model na vlastnom serveri taký dobrý ako ChatGPT alebo Claude?

Na zhrnutia, odpovede z dokumentov, vyťahovanie údajov a návrhy textov sú súčasné otvorené modely pre väčšinu interného použitia dosť dobré. Pri náročnom uvažovaní a dlhých zložitých úlohách sú najlepšie komerčné modely stále vpredu. Oboje otestujeme na vašich skutočných otázkach, aby ste rozdiel videli ešte pred rozhodnutím.

Koľko to stojí?

Súkromný asistent s viacerými zdrojmi a oprávneniami sa zvyčajne zmestí do nášho pásma pre prepojené systémy, teda 10 – 30 tis. €. Pilot nad jedným zdrojom môže vyjsť na 5 – 10 tis. €. Hardvér alebo prenájom GPU sú samostatné prevádzkové náklady, ktoré odhadneme vopred. Cenu vývoja zafixujeme po úvodnom workshope.

Vyrieši to GDPR a európsky AI Act?

Odpadne jedna veľká otázka: ktorá externá firma vaše dáta spracúva. GDPR však stále platí pre to, čo ukladáte a ako dlho, a AI Act pridáva povinnosti podľa toho, na čo systém slúži. Pomôžeme riešenie zdokumentovať, ale nie je to právna rada. Potvrdiť by ho mala vaša zodpovedná osoba alebo právnik.

Bude asistent rešpektovať naše súčasné oprávnenia?

Áno. Overí, kto sa pýta, a prehľadá len dokumenty a záznamy, ktoré tento človek môže otvoriť v zdrojovom systéme. Obchodník teda nedostane odpoveď z personálnych spisov.

Budete model trénovať na našich dátach?

Zvyčajne nie. Model si pri každej otázke prečíta relevantné pasáže (RAG). Je to lacnejšie, odpovede sú aktuálne a mazanie dát je jednoduché. Doladenie modelu (fine-tuning) sa oplatí len v úzkych prípadoch, napríklad pri pevnom formáte výstupu alebo špecializovanej klasifikácii vo veľkom objeme.

Kto ho bude po spustení prevádzkovať a aktualizovať?

Kód, konfigurácia aj účty sú vaše. Prvé 3 mesiace opravujeme chyby zadarmo. Potom sa o aktualizácie a monitoring môžeme starať v mesačnej podpore, alebo všetko odovzdáme vášmu IT.

Ako dlho trvá pilot?

Prvá verzia zvyčajne trvá 6 týždňov až 3 mesiace podľa počtu zdrojov a toho, či už máte hardvér. Ak začnete na prenajatých GPU, nemusíte čakať na dodanie hardvéru.

Ktoré dáta nesmú opustiť vašu firmu?

Napíšte nám, o aké dáta ide a čo vyžadujú vaše pravidlá. Povieme vám, či vlastný server vôbec potrebujete a koľko by stálo prvé použitie.

JurajCEO, QikBuild

Z hovoru si odnesiete

  • Návrh, čo by sme postavili ako prvé
  • Orientačnú cenu
  • Odpoveď, či sa vám oplatí softvér na mieru
Dohodnúť 30-minútový hovor

Alebo napíšte na hello@qikbuild.com